Nous optimisons les sites pour les bots. Mais savons-nous vraiment ce qu’ils font ?
CV
Charles Vayssié Journey Further & Scrubnet
24 sections · Logs d’accès, comportement des crawlers et signaux de fraîcheur
Cette conférence comporte deux parties : l’analyse concrète des logs d’accès en SEO technique, puis les signaux de fraîcheur et les observations de Scrubnet qui soulèvent de nouvelles questions. Consultez les explications ci-dessous ou utilisez Présenter pour parcourir la conférence comme un diaporama.
01 / Présentation rapide
Bonjour, moi c’est Charles.
Spécialiste du SEO technique, développeur web et fondateur de Scrubnet.
Charles Vayssié
Journey Further
Un SEO technique fondé sur les faits.
Des sites e-commerce et internationaux complexes, de l’investigation technique aux améliorations concrètes.
Scrubnet
Un espace pour créer et explorer.
Des outils de SEO et des recherches sur les crawlers, dont SEO Scrubbox et l’Observatoire de fraîcheur.
GET demande la ressource HTML à ce chemin. Le champ indique la représentation demandée, pas seulement le sujet qui a attiré l’attention.
L’horodatage
Placer la requête sur une chronologie.
L’horodatage inclut un décalage de fuseau horaire. Alignez les fuseaux avant de comparer le crawl avec les déploiements, les mises à jour et les incidents.
La réponse
Un statut et un volume transféré.
200 est le statut de réponse enregistré. Dans le format de cet exemple, 12418 est la taille du corps de réponse en octets. Une réponse réussie ne prouve pas l’indexation.
L’identité déclarée
Un user-agent est une déclaration.
Cette ligne se présente comme Googlebot. Il faut vérifier séparément l’adresse IP source selon la procédure documentée par le fournisseur.
Cette ligne est fictive et utilise une adresse IP réservée à la documentation. Elle ne prouve pas une visite vérifiée de Googlebot.
L’origine du log compte. Un log du serveur d’origine peut manquer les requêtes servies entièrement par un CDN. Les logs du CDN et du serveur peuvent décrire des étapes différentes d’une même requête. Les champs, tailles de réponse et mesures de temps disponibles dépendent de la configuration.
Quelle partie du parcours votre log a-t-il réellement vue ?
Un CDN et un serveur d’origine observent des étapes différentes d’une requête.
01
Crawler
Demande l’URL.
02
CDN / périphérie
Peut servir le cache ou filtrer.
03
Origine
Reçoit la requête si elle est transmise.
Logs du serveur
Apache / NGINX / hébergeur
Commencez par la destination configurée des logs d’accès ou l’export de requêtes de votre hébergeur.
Logs du CDN
Cloudflare / Akamai / autres CDN
Vérifiez l’export, les champs, la rétention et la couverture du fournisseur. Un accès servi depuis le cache du CDN peut être absent des logs d’origine.
Une fois l’émetteur identifié, ajoutez l’état technique de l’URL et ses performances de recherche.
Logs d’accès
Qu’est-ce qui a été demandé ?
Crawler, ressource, date, réponse et, si disponibles, volume transféré ou temps de traitement.
Screaming Frog
Quels signaux l’URL expose-t-elle ?
Une photographie du statut, des canonicals, de l’indexabilité, des liens internes et d’autres éléments techniques.
Google Search Console
Que rapporte Google ?
Les performances de recherche, les rapports d’indexation et l’inspection d’URL ajoutent un autre point de vue.
03 / Transformer les logs en analyses SEO
Réunir ces données : Bot Control.
L’approche du tableau de bord de Journey Further : passer de données séparées à une investigation.
VUE CROISÉE ILLUSTRATIVE URL et valeurs fictives · Exemple sur sept jours
Exemple fictif réunissant des données de crawl, de logs d’accès et de Google Search Console sur sept jours.
Page d’exemple
Indexable¹
Requêtes vérifiées²
5xx²
Clics de recherche³
/guides/log-analysis/
Oui
2
0
140
/guides/crawl-signals/
Oui
640
48
310
/search/?sort=latest
Non
1 280
0
0
QUESTION SUIVANTE →
Cette page indexable reçoit des clics de recherche, mais peu de requêtes de bots. Est-ce cohérent avec ses mises à jour et son historique de crawl ?
¹ Crawl Screaming Frog² Logs d’accès³ Google Search Console
Une piste à examiner, pas un diagnostic automatique. Un faible nombre de requêtes ne prouve pas un problème de crawl. Une forte activité sur une URL non indexable n’est pas automatiquement du gaspillage. Vérifiez le rôle de la ressource, la période observée, la vérification des identités et la couverture des logs.
Ce schéma illustre la conférence : ce n’est ni une capture de Bot Control ni un résultat client. Les URL et les valeurs fictives expliquent la méthode sans représenter de données ou de résultats mesurés chez un client.
03 / Transformer les logs en analyses SEO
Trouver les requêtes que les autres rapports ne montrent pas en détail.
Identifiez l’URL, le crawler et l’horodatage des échecs et des requêtes interrompues.
Repérer
Ressources absentes ou bloquées
Repérez les requêtes 404 et 410 , les blocages d’accès comme 403et les limitations de débit signalées par 429.
Relier
Quels bots demandent quelles URL ?
Regroupez les requêtes par crawler, modèle d’URL et période pour repérer les ressources concernées et les chemins récurrents.
Repérer
Les échecs réellement rencontrés par les bots
Repérez les réponses 500, 502 et 503 dans les requêtes de crawlers, y compris lors d’incidents brefs.
Relier
La requête et l’heure exactes
Reliez les échecs aux pages importantes, à l’activité de l’origine ou du CDN et aux temps de réponse enregistrés. Vérifiez si les requêtes suivantes ont réussi.
Repérer · Logs NGINX
Requêtes interrompues
499 signale une déconnexion du client avant l’envoi des en-têtes par NGINX. Les logs donnent l’URL, l’heure et le client enregistré.
Visibilité supplémentaire
Un détail que Search Console ne peut pas nommer 499
C’est un code local de journalisation, pas une réponse HTTP envoyée à Googlebot. Search Console peut signaler un problème de récupération, mais n’expose pas votre ligne de log NGINX 499.
04 / Signaux de fraîcheur : les bots écoutent-ils ?
Les signaux de fraîcheur ont des rôles différents.
Publication, mises à jour éditoriales, changements de page et versions HTTP décrivent des événements différents.
<lastmod>2026-11-01</lastmod>
Mise à jour significative de la page
Quand cette URL a-t-elle changé de façon significative ?
Sitemap lastmod peut refléter des changements importants du contenu, des liens ou des données structurées. Ce n’est pas simplement la date de génération du sitemap.
"dateModified":
"2026-11-01T10:00:00Z"
Contenu éditorial
Quand ce contenu a-t-il été mis à jour ?
Les données structurées peuvent décrire l’article ou une autre entité de la page. Comparez les dates du même élément ; le lastmod du sitemap décrit l’URL dans son ensemble.
Last-Modified:
Sun, 08 Nov 2026 10:00:00 GMT
Mise à jour de la représentation HTTP
Quand la ressource servie a-t-elle changé ?
Un fichier HTML régénéré ou redéployé peut avoir une date HTTP plus récente sans modification éditoriale. Une date plus récente que lastmod ou dateModified n’est pas automatiquement incohérente.
ETag: "feed-html-v7"
Validateur de représentation HTTP
Cette version correspond-elle toujours ?
Un ETag identifie une version de représentation, pas une date de publication. Le client peut envoyer If-None-Match pour valider sa copie en cache.
"datePublished": "2026-07-20"

Publié le : 20 juillet 2026
Mis à jour le : 1er novembre 2026
Publication et contexte pour le lecteur
Créé, puis mis à jour de façon significative.
La publication et la mise à jour éditoriale sont deux événements distincts. Les dates visibles doivent l’expliquer clairement et correspondre au contenu décrit.
Exemple de calcul d’âge · toutes les heures sont en UTC
Mise à jour enregistrée
Requête du crawler
Âge lors de la requête3 jours
Source de la date : JSON du flux dateModified, avec repli sur la date du fichier.
Heure de requête − date de modification stockée de la ressource.
L’étude publiée couvre les requêtes vérifiées dont l’âge est exploitable, en HTML, Markdown, TXT et JSON. Elle ne mesure ni l’indexation ni l’entraînement.
Les contenus anciens recevaient encore la plupart des requêtes.
Une observation historique issue des 28 premiers jours rapportés par l’Observatoire de fraîcheur de Scrubnet.
88%
des requêtes observées visaient du contenu de plus de sept jours.
Un jour au maximum4%
Plus d’un jour, jusqu’à sept jours8%
Plus de sept jours88%
Qu’est-ce qui pourrait l’expliquer ?
Explications possibles
Cycles de revisite : les bots pourraient revenir aux ressources connues selon des cycles établis.
Contenu disponible : les anciennes URL pourraient constituer l’essentiel des ressources accessibles.
Autres priorités : la découverte, les liens et les objectifs propres au crawler pourraient intervenir en plus de l’âge.
Plusieurs facteurs pourraient contribuer à cette répartition des requêtes.
Photographie historique, pas un tableau de bord en direct. Ces pourcentages approximatifs proviennent de Signaux de fraîcheur et réalité du crawl, publié le . L’article décrit une première fenêtre de 28 jours ; sa publication ne donne pas les dates exactes de début et de fin de cette période.
L’interprétation nécessite la répartition par âge des ressources disponibles, la définition de l’âge enregistré et les autres influences sur le crawl. Cette observation ne prouve ni l’indexation, ni le classement, ni l’entraînement d’IA, ni l’effet causal d’un signal. Les chiffres décrivent cette fenêtre historique et non l’état actuel de l’outil.
05 / Mes premières observations
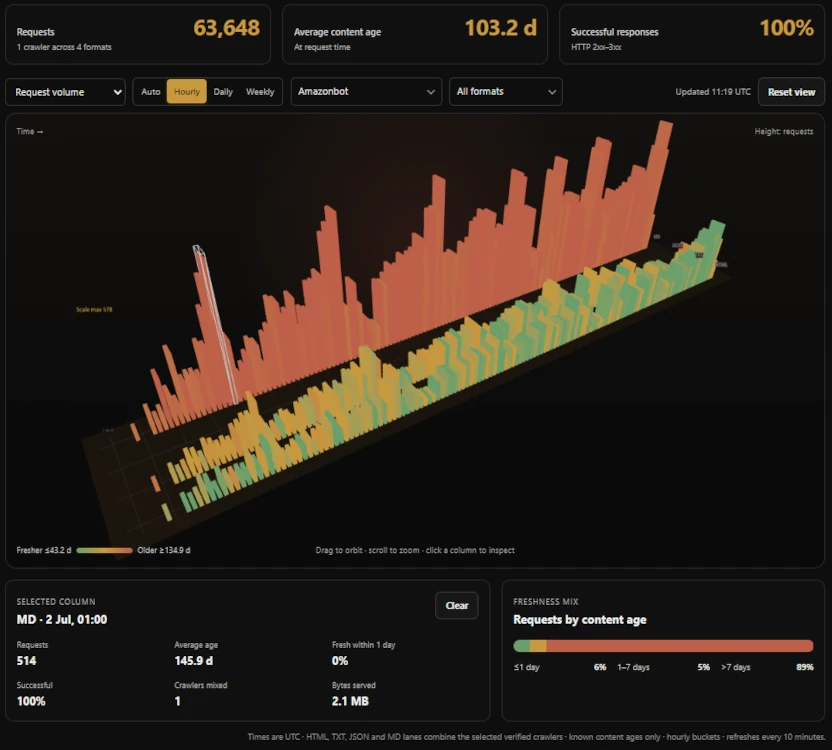
Les crawlers ne suivaient pas un même schéma.
Observations historiques de l’étude Scrubnet publiée sur 28 jours.
Formats enregistrés
Les quatre formats
Googlebot et GoogleOther ont demandé HTML, Markdown, TXT et JSON.
Chronologie des requêtes
Un pic TXT au même moment
Les deux crawlers ont produit un pic important de requêtes TXT à peu près au même moment.
Formats enregistrés
Principalement HTML
HTML recevait la majorité des requêtes de Bingbot dans les données sélectionnées.
Activité Markdown
Très peu de requêtes
Très peu d’activité Markdown a été enregistrée pendant la période observée.
Activité Markdown
Environ deux fois plus de requêtes
Amazonbot a demandé Markdown environ deux fois plus souvent que HTML ou TXT, pris séparément.
Activité JSON
Aucune requête observée
Aucune requête Amazonbot vers des ressources JSON n’a été enregistrée dans ces données.
Activité Markdown
Des rafales concentrées
Le crawler externe de Meta a demandé des groupes de ressources Markdown lors de pics importants.
Autres formats
Plus répartis dans le temps
Ses requêtes HTML, TXT et JSON étaient comparativement plus réparties sur la période.
Chronologie des requêtes
Une faible activité, puis de grands pics
ClaudeBot a maintenu une activité relativement faible pendant une grande partie de la période, interrompue par quelques pics importants.
Formats enregistrés
Les quatre formats
Les quatre formats ont été demandés, HTML recevant le plus grand volume total de requêtes.
La configuration actuelle de Scrubnet sert à observer. Elle ne suit pas encore un protocole d’expérimentation contrôlée.
Cadre observé
Un site, une configuration
Les flux de Scrubnet, ses ressources et la fenêtre de 28 jours sélectionnée. Un autre site peut présenter un comportement différent.
Méthode de l’étude
Pas de comparaison contrôlée
Les formats et les ressources n’étaient pas des traitements répartis aléatoirement. Plusieurs facteurs varient ensemble : cette configuration n’isole pas les causes.
Comment les utiliser
Des questions à explorer
Ces tendances donnent matière à réflexion. Elles ne constituent pas encore des recommandations générales de crawl, de formats ou de fraîcheur pour d’autres sites.
Rattachez chaque observation à son site, ses ressources et sa période.
Des signaux exacts. Un contexte de crawl plus large.
Gardez des informations de fraîcheur pertinentes. Leur influence sur les revisites reste difficile à isoler.
Ce que nous pouvons faire
Décrire les changements fidèlement
Gardez les signaux de publication, éditoriaux, du sitemap et HTTP cohérents avec leur rôle. Les dates ne doivent pas forcément être identiques.
Ce qui reste incertain
L’effet de chaque signal sur le crawl
Découverte, liens, comportement du serveur et priorités des crawlers forment un contexte plus large. Ces observations n’isolent pas l’effet d’un signal.
Je documente ce qui se passe sur Scrubnet et partage ces observations à mesure que les données s’accumulent.
06 / Il reste tant à découvrir
Il reste tant à découvrir.
« Plus nous observons le comportement des bots, plus nous réalisons tout ce qu’il reste à apprendre. »
Sources techniques externes vérifiées le ; références sur les sitemaps, la fraîcheur HTTP et les rapports de requêtes revues le . Les chiffres de Scrubnet sont historiques et proviennent de l’article publié le 20 juillet 2026. Les exemples Bot Control sont fictifs et ne contiennent aucune donnée client.
06 / Garder le contact
Merci.
Des questions ou des observations ? Poursuivons la conversation.